
Ciência de dados é a área que usa estatística, programação e conhecimento do negócio para transformar dados em decisões melhores: formular a pergunta, coletar e limpar os dados, analisar, construir modelos quando eles ajudam e testar se a decisão tomada com eles melhorou o resultado. O modelo é uma etapa; a decisão testada é o produto.
Uma operadora regional de internet tinha 180 mil assinantes e perdia perto de 2,4% deles por mês. A diretoria contratou um time de dados. Em três meses saiu um modelo de previsão de cancelamento com 91% de acurácia no conjunto de teste. A decisão veio rápido: os 2.000 clientes com maior risco de sair receberiam 30% de desconto por seis meses.
Seis meses depois, o cancelamento continuava em torno de 2,4%. O desconto custou cerca de R$ 1,1 milhão. O modelo não estava errado: ele acertava quem ia sair. O problema é que boa parte de quem ia sair estava se mudando para fora da área de cobertura, e nenhum desconto segura cliente que muda de cidade. A pergunta que o modelo respondia (quem vai cancelar?) não era a pergunta que a diretoria precisava responder (em quem uma ação nossa muda o resultado?).
O que é ciência de dados?
Ciência de dados, definida pelo que ela resolve, é o trabalho de transformar dados em decisões que dão resultado melhor do que as decisões tomadas sem eles. Ela junta três coisas: estatística (como a variação e a incerteza funcionam), computação (como lidar com volume, limpeza e automação) e conhecimento do processo (o que os números significam no mundo real).
A palavra que costuma faltar nas definições é “decisão”. Um painel bonito, um modelo com acurácia alta ou um relatório de cinquenta páginas não são ciência de dados se ninguém decide nada diferente por causa deles, ou se ninguém mede se a decisão funcionou.
Ciência de dados, estatística e BI: qual a diferença?
As três áreas se sobrepõem, e quem está começando costuma confundir. A diferença está na pergunta que cada uma responde melhor:
| Estatística | Business Intelligence (BI) | Ciência de dados | |
|---|---|---|---|
| Pergunta típica | Essa diferença é real ou é variação? | O que aconteceu e onde? | O que vai acontecer e o que fazer? |
| Entrega | Inferência, intervalo, teste, desenho de experimento | Painéis, relatórios, indicadores | Modelos, previsões, automação de decisões |
| Ferramentas comuns | R, Minitab, planilhas | Power BI, Looker, SQL | Python, R, SQL, bibliotecas de machine learning |
| Risco quando falta método | Teste certo para a pergunta errada | Comparar dois pontos e chamar de tendência | Modelo preciso que não muda resultado |
Na prática, um bom cientista de dados usa as três. O BI mostra onde olhar, a estatística diz se o que se vê é sinal ou ruído, e o modelo ajuda a decidir em escala.
O que faz um cientista de dados no dia a dia
As pesquisas com profissionais da área repetem um dado conhecido: a maior parte do tempo vai para encontrar, entender e limpar dados, não para treinar modelos. O ciclo típico tem cinco etapas:
- Formular a pergunta com quem decide: que decisão vai mudar, e como saberemos se mudou para melhor?
- Coletar e preparar os dados: juntar fontes, tratar ausentes, conferir definições operacionais (o que conta como “cancelamento”? pedido feito ou linha desligada?).
- Explorar: gráficos, distribuições, séries no tempo. Aqui aparecem os erros de registro e as surpresas.
- Modelar, quando um modelo ajuda: regressão, classificação, séries temporais, agrupamento.
- Testar a decisão: colocar a mudança em campo de forma controlada e medir o efeito.
A etapa 5 é a que mais falta. É ela que separa um projeto que gera relatório de um projeto que gera resultado.
Por que o método vem antes do modelo
Volte à operadora. O que teria mudado a história não era um algoritmo melhor. Era tratar a campanha como um teste: oferecer o desconto para metade dos clientes de alto risco, escolhida por sorteio, e comparar o cancelamento dos dois grupos durante três meses. Com 1.000 clientes em cada grupo, uma diferença de 4 pontos percentuais apareceria com clareza; a ausência de diferença, também. O custo do teste seria metade do custo da campanha, e a resposta viria antes de gastar o resto.
Esse é o raciocínio do ciclo PDSA: antes de agir, escrever a predição (“o desconto vai reduzir o cancelamento desse grupo de 9% para 5%”), testar pequeno, estudar o resultado e só então ampliar. A predição é o que transforma uma ação em aprendizado.
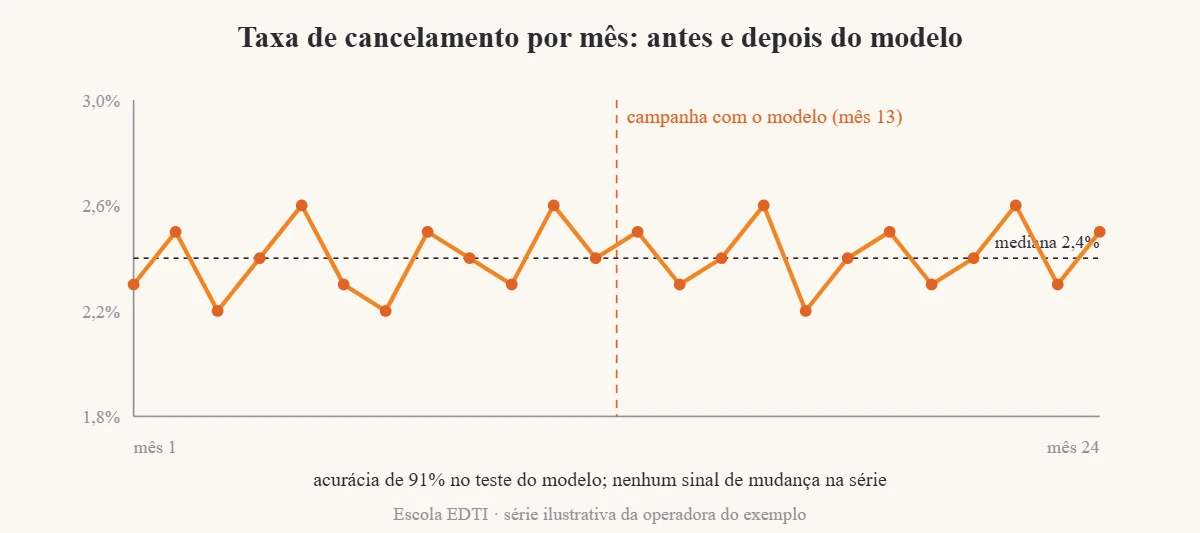
O gráfico mostra o segundo ponto de método: olhar os dados no tempo. Quem compara “cancelamento de março” com “cancelamento de setembro” pode ver uma queda de 2,6% para 2,3% e celebrar. Quem olha os 24 meses vê que 2,3% já aconteceu cinco vezes antes da campanha. É variação de causas comuns, não efeito. A carta de controle e o gráfico de tendência existem para fazer essa leitura com regra, e não no olho.
Conexões: onde a ciência de dados encontra outras ferramentas
Quem estuda ciência de dados acaba passando por um conjunto de temas que o site da Escola EDTI trata em peças próprias:
- Estatística básica: média, desvio, distribuição, a base de qualquer modelo.
- Regressão linear: o primeiro modelo que todo cientista de dados aprende, e o que mais se usa mal.
- Teste de hipótese: como saber se a diferença entre os grupos do teste é real.
- People analytics: ciência de dados aplicada a gestão de pessoas, com os mesmos cuidados.
- Excel: onde a maior parte das análises de empresa ainda começa, e onde dá para fazer muito antes do Python.
Em projetos de melhoria estruturados, como os conduzidos na formação Green Belt, essas ferramentas entram dentro do DMAIC: a pergunta vira contrato de projeto, a exploração vira a fase de medição, o modelo vira análise e o teste da decisão vira a fase de melhoria.
Como começar em ciência de dados
O caminho mais comum passa por estatística, SQL e uma linguagem (Python ou R), nessa ordem de importância para o trabalho real. Cursos de graduação em estatística, ciência da computação, engenharia e economia formam boa parte dos profissionais; muitos vêm de outras áreas e aprendem em cursos livres e pós-graduações.
O que diferencia quem cresce na área não é saber mais algoritmos. É saber conversar com quem decide, escrever a pergunta certa e desenhar o teste que mostra se a decisão funcionou. Isso é método, e se aprende antes de qualquer linguagem.
O modelo de previsão leva o trabalho até a pergunta “quem tem mais risco?”. Daqui em diante, o problema é de outra natureza: decidir onde agir e provar que a ação muda o resultado. Essa parte pertence ao desenho de experimentos e ao ciclo PDSA, e é ali que a maioria dos projetos de dados ganha ou perde o investimento.
Conteúdo revisado pelo Master Black Belt Marcelo Petenate, estatístico, formado pela Unicamp, mestre pela USP e especialista em Lean Six Sigma e melhoria contínua.
Nesta revisão, o foco foi a diferença entre a acurácia de um modelo e o efeito da decisão tomada com ele.
Entender ciência de dados na teoria é o primeiro passo. O segundo é ver como uma pergunta vira dado, análise, decisão e teste dentro de um projeto conduzido do início ao fim, com resultado mensurável. O curso gratuito White Belt da Escola EDTI foi desenvolvido para dar esse primeiro passo com o método que antecede qualquer modelo.
Perguntas frequentes sobre ciência de dados
O que faz um cientista de dados?
Formula perguntas com quem decide, prepara e explora dados, constrói modelos quando eles ajudam e mede se as decisões tomadas com base neles melhoraram o resultado.
Qual a diferença entre ciência de dados e estatística?
A estatística é uma das bases da ciência de dados. A ciência de dados acrescenta computação em escala, engenharia de dados e automação de decisões; a estatística dá o raciocínio sobre variação e incerteza que evita conclusões falsas.
Qual a diferença entre ciência de dados e BI?
O BI descreve o que aconteceu, em painéis e relatórios. A ciência de dados tenta prever e orientar o que fazer. As duas dependem de dados bem definidos.
Preciso saber programar para trabalhar com ciência de dados?
Para a maioria das vagas, sim: SQL e Python ou R são exigidos com frequência. Mas muita análise útil começa no Excel, e o raciocínio estatístico vale mais do que a ferramenta.
Ciência de dados é o mesmo que inteligência artificial?
Não. Inteligência artificial e machine learning são conjuntos de técnicas que a ciência de dados pode usar. Boa parte do trabalho de ciência de dados não envolve modelos complexos.
Por que tantos projetos de dados não dão resultado?
Porque param no modelo. Sem uma pergunta ligada a uma decisão e sem um teste que mostre o efeito dessa decisão, o projeto entrega precisão, não resultado.
O que estudar depois de entender o que é ciência de dados?
Estatística básica, leitura de dados no tempo (gráfico de tendência e carta de controle) e desenho de testes. São a base do curso gratuito White Belt da Escola EDTI e de qualquer projeto de dados que precise provar resultado.