
O escore Z (ou z-score) é o número de desvios-padrão que separa um valor da média do seu grupo. Calcula-se com z = (x − média) ÷ desvio-padrão. Serve para comparar valores medidos em escalas diferentes, localizar dados distantes e, quando a distribuição é aproximadamente normal, estimar que fração dos valores fica acima ou abaixo de um ponto.
Existe uma crença que acompanha o escore Z desde a primeira aula: “z acima de 3 é raro, então é erro”. A frase parece prudente e quase sempre é aplicada sem pergunta nenhuma. Ela falha por dois motivos que esta página mostra com números: o escore Z não sabe se os dados são normais, e ele não sabe se o processo mudou no meio do caminho.
O escore Z mede distância. A raridade é outra coisa, e depende de hipóteses que o cálculo não verifica.
O que é o escore Z?
É uma régua comum. O escore Z troca a unidade original (gramas, pontos, minutos) pela unidade “desvios-padrão a partir da média”. Um z de +2 significa dois desvios-padrão acima da média; um z de −1,5, um desvio e meio abaixo.
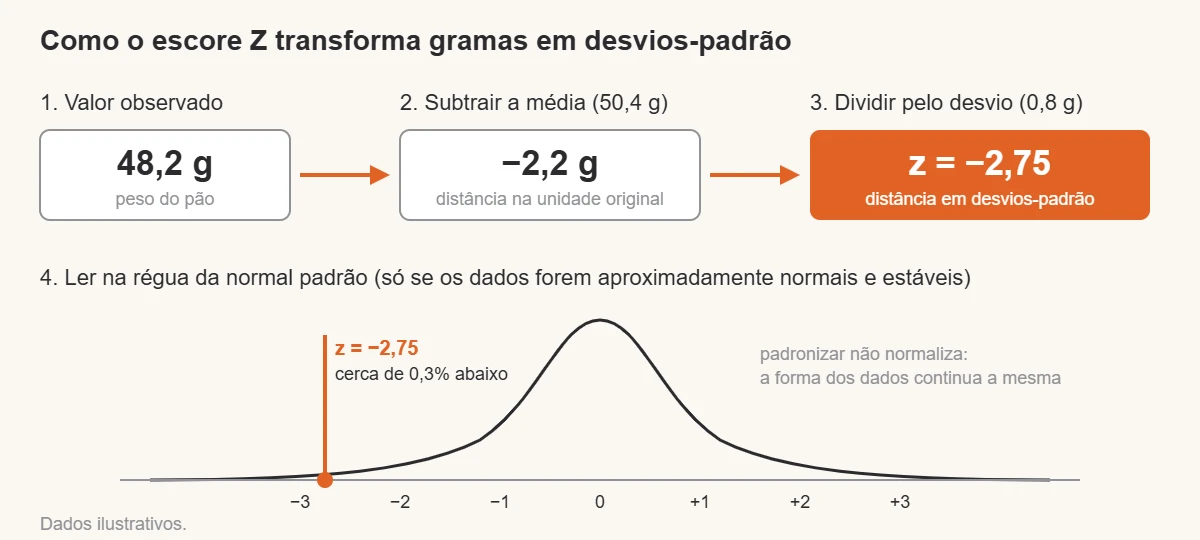
Por isso o escore Z também é chamado de valor padronizado, nota padronizada ou variável reduzida. Depois da padronização, qualquer conjunto de dados passa a ter média 0 e desvio-padrão 1. A forma da distribuição, porém, continua a mesma: se os dados eram assimétricos antes, continuam assimétricos depois.
Padronizar não normaliza.
Como calcular o escore Z
A fórmula tem duas operações, e cada uma tem um papel:
z = (x − μ) ÷ σ
Em que x é o valor observado, μ é a média e σ é o desvio-padrão. Quando você só tem uma amostra, usa a média amostral (x̄) e o desvio-padrão amostral (s) no lugar de μ e σ.
A subtração desloca: ela diz quanto o valor está longe do centro, na unidade original. A divisão converte: ela troca a unidade original pela unidade de dispersão do próprio grupo. Um afastamento de 2 g pode ser enorme numa linha que varia 0,5 g e irrelevante numa linha que varia 10 g. A divisão é o que coloca as duas situações na mesma régua.
Responda antes de continuar: uma aluna tirou 78 em Estatística (turma com média 70 e desvio-padrão 5) e 85 em Cálculo (média 80 e desvio-padrão 10). Em qual prova o desempenho dela foi relativamente melhor?
A nota maior é a de Cálculo. O escore Z diz o contrário. Em Estatística, z = (78 − 70) ÷ 5 = 1,6. Em Cálculo, z = (85 − 80) ÷ 10 = 0,5. Ela ficou 1,6 desvio-padrão acima da turma em uma prova e meio desvio-padrão na outra.
Para que serve o escore Z
Os usos mais comuns aparecem em quatro situações. A primeira é comparar valores de escalas diferentes, como as duas notas acima, o desempenho de filiais de tamanhos diferentes ou medidas de laboratório com unidades distintas. A segunda é sinalizar valores distantes do grupo, o ponto de partida para investigar um outlier. A terceira é ler probabilidades na tabela da normal padrão, quando os dados permitem. A quarta é servir de peça para outros cálculos: o índice Cpk, por exemplo, é a menor distância entre a média e um limite de especificação, medida em desvios-padrão e dividida por 3.
Nos quatro usos o escore Z responde à mesma pergunta: “quão longe, na régua deste grupo?”. O que muda é o que se faz com a resposta.
Escore Z e distribuição normal: quando o z vira probabilidade
Se os dados seguem uma distribuição aproximadamente normal, o escore Z vira probabilidade com a regra 68-95-99,7: cerca de 68% dos valores ficam entre z = −1 e z = +1, 95% entre −2 e +2 e 99,7% entre −3 e +3. É dessa regra que nasce a ideia de que |z| acima de 3 é raro.
“Mas o software calcula a probabilidade para qualquer conjunto de dados”, dirá alguém. Calcula, e calcula com toda a confiança. Só que a conta parte do pressuposto de que a curva é normal. Em tempos de espera, que costumam ter cauda longa à direita, valores com z = +3 aparecem muito mais do que 0,13% das vezes. Ninguém errou a conta; a hipótese é que não valia.
Antes de traduzir escore Z em porcentagem, olhe o histograma e, melhor ainda, os dados em ordem de tempo.
Calculadora de escore Z
Digite o valor, a média e o desvio-padrão. A calculadora devolve o escore Z e a fração aproximada de valores abaixo dele, sob a hipótese de normalidade.
Calculadora de escore Z
z = -2,75 · se a distribuição for aproximadamente normal, cerca de 0,3% dos valores ficam abaixo deste ponto.
A porcentagem usa a aproximação da curva normal padrão (erro menor que 0,0002). Ela só tem sentido se os dados vierem de um processo estável e com forma próxima da normal.
Exemplo de escore Z em um processo
Uma padaria industrial produz pães com peso nominal de 50 g. Nos últimos dias, a média foi 50,4 g e o desvio-padrão foi 0,8 g. Um pão sai com 48,2 g. O escore Z é (48,2 − 50,4) ÷ 0,8 = −2,75. Na normal padrão, cerca de 0,3% dos pães ficariam abaixo desse peso.
A conclusão tentadora é “pão estranho, deve ser erro de balança, descarta”. Mas olhe o que acontece quando os 200 pesos do período são colocados em ordem de produção. Nas primeiras 120 unidades, a média era 50,9 g. Depois de uma troca de lote de farinha, caiu para 49,7 g. O desvio-padrão “de 0,8 g” mistura dois processos diferentes, e o pão de 48,2 g pertence ao segundo, onde ele está a pouco mais de 2 desvios da média local.
O escore Z calculado sobre o conjunto inteiro escondeu a mudança. Quem olhou os dados no tempo viu uma causa especial com data e hora; quem olhou só o z viu um ponto estranho. É a diferença entre ler pontos isolados e ler o processo, a mesma lógica do gráfico de tendência e das cartas de controle.
Escore Z com dados da amostra: o limite que pouca gente conhece
Há um detalhe matemático que desmonta a regra “z acima de 3 é erro” em amostras pequenas. Quando a média e o desvio-padrão são calculados com os mesmos dados que você está avaliando, o maior escore Z possível é limitado pelo tamanho da amostra: |z| nunca passa de (n − 1) ÷ √n.
Com n = 10, esse teto é 2,85. Ou seja, numa amostra de dez valores, nenhum ponto consegue ter z acima de 3, por mais absurdo que seja. Um único valor muito distante infla o desvio-padrão e, com isso, encolhe o próprio escore Z. O efeito tem nome: mascaramento.
Na prática, isso pede duas cautelas. Em amostras pequenas, prefira olhar o gráfico dos dados a aplicar um corte fixo. E, quando houver uma referência estável (um período anterior do processo, por exemplo), calcule o escore Z com a média e o desvio-padrão dessa referência, e não com os dados que estão sob suspeita.
Onde o escore Z entra no método
Na formação Green Belt, o escore Z aparece na fase Medir do DMAIC, quando a capabilidade do processo é estimada, e volta na fase Controlar, onde o que interessa é a estabilidade no tempo e não a distância de um ponto isolado. O hub de estatística básica reúne os conceitos que vêm antes.
A advertência que fica: o caso do ponto descartado
Em uma linha de envase de um laboratório de cosméticos (caso ilustrativo), a analista calculou o escore Z dos volumes de 30 frascos e descartou o único com |z| acima de 3 como “erro de leitura”. Duas semanas depois, o mesmo valor reapareceu quatro vezes num só turno. Era o primeiro sinal de um bico de envase desgastado. O cálculo estava certo; a decisão de descartar, sem olhar a ordem dos dados e sem perguntar o que mudou, é que estava errada.
O escore Z responde “quão longe”. Por que o ponto está longe, e se isso vai se repetir, é pergunta de processo, e só se responde com os dados no tempo e com quem conhece a operação.
Conteúdo revisado pelo Master Black Belt Marcelo Petenate, estatístico, formado pela Unicamp, mestre pela USP e especialista em Lean Six Sigma e melhoria contínua.
Nesta revisão, o foco foi a diferença entre distância em desvios-padrão e raridade, e o efeito de mascaramento em amostras pequenas.
Se você quer praticar a leitura de dados no tempo antes de padronizar qualquer coisa, o curso White Belt gratuito da Escola EDTI começa exatamente por aí: variação, causas comuns e especiais e as primeiras ferramentas para separar sinal de ruído.
Perguntas frequentes sobre escore Z
Escore Z pode ser negativo?
Pode. O sinal só indica o lado: z negativo significa valor abaixo da média; z positivo, acima. Um z de −2 está tão longe da média quanto um z de +2.
Qual a diferença entre escore Z e escore T?
Na estatística descritiva, o escore T é uma reescala do escore Z (T = 50 + 10z) para evitar números negativos. Não confunda com a estatística t do teste t de Student, que usa o desvio-padrão da amostra e segue a distribuição t.
Como calcular o escore Z no Excel?
Use a função PADRONIZAR(x; média; desvio_padrão). Para a probabilidade acumulada na normal padrão, use DIST.NORMP.N(z; VERDADEIRO). Mais ideias no hub de Excel.
Escore Z serve para dados que não são normais?
Serve para medir distância e comparar escalas. Não serve para ler probabilidade na tabela da normal. Para dados assimétricos, use percentis calculados a partir dos próprios dados.
Qual valor de escore Z indica um outlier?
Não há um corte universal. |z| acima de 3 é uma convenção para dados aproximadamente normais e amostras grandes. Em amostras pequenas, o teto (n − 1) ÷ √n pode impedir que qualquer ponto passe de 3.
Que erro as pessoas mais cometem com o escore Z?
Calcular a média e o desvio-padrão misturando períodos em que o processo mudou, e depois usar o z para descartar pontos. Na Escola EDTI, o escore Z é ensinado junto com os gráficos no tempo justamente para evitar essa armadilha: primeiro estabilidade, depois distância.